Un weekend avec Claude, un monolithe et un nouveau Studio

Ce weekend, RuleShake a changé d'architecture et de visage. Les microservices sont regroupés dans une seule application, MongoDB a laissé la place à PostgreSQL, et RuleShake Studio a quitté Vuetify pour shadcn-vue et Tailwind CSS. Le tout en trois jours, du vendredi au dimanche, et je n'ai pas écrit ce code seul : il a été réalisé par Claude, l'IA d'Anthropic, avec Claude Code.
Pourquoi revenir à un monolithe ?
En 2023, j'avais présenté l'architecture de RuleShake : des services autonomes (Catalog, Runner, Referential), chacun avec sa base MongoDB, en Spring WebFlux réactif de bout en bout.
Sur le papier, c'était séduisant. En pratique, ce découpage coûtait plus qu'il ne rapportait :
- trois déploiements à maintenir, et des clients HTTP versionnés entre les services ;
- un aller-retour réseau sur le chemin critique : le Runner interrogeait Referential à chaque évaluation ;
- un bug caché dès qu'on passe à plusieurs réplicas : le Runner garde les collections publiées en mémoire, une publication n'atteint que le pod qui la reçoit ;
- et un seul service, le Runner, a réellement un profil de charge différent.

Pourquoi abandonner le réactif ?
Le choix de Spring WebFlux venait surtout de MongoDB, qui propose un client réactif : autant être réactif de bout en bout. Mais ce modèle a un prix :
- le code métier devient une chaîne de
Monoet deFlux, plus difficile à écrire, à relire et à faire évoluer qu'un code impératif ; - le débogage est pénible : les piles d'appels ne disent plus grand-chose, une erreur oubliée dans une chaîne peut disparaître silencieusement ;
- l'évaluation d'une collection consomme surtout du CPU : le réactif n'y apporte rien ;
- en passant à PostgreSQL, l'accès aux données redevient JDBC, bloquant par nature.
Depuis Java 21, les threads virtuels donnent la même capacité à tenir de nombreuses requêtes simultanées, avec du code impératif classique. ruleshake-server les active : on garde les performances, et le code redevient simple.
Ce qui a changé côté serveur
Les trois services (et la librairie de sécurité partagée) sont réunis dans ruleshake-server, un monolithe modulaire :
- Spring Boot 4 et Java 25, en servlet classique plutôt qu'en réactif ;
- Spring Modulith découpe l'application en modules
catalog,referential,runtimeetshared. Les frontières entre modules sont vérifiées par un test : un module ne peut pas lire les tables d'un autre ; - PostgreSQL remplace MongoDB, avec un schéma par module. Les datasets du référentiel deviennent de vraies tables SQL ;
- le moteur de calcul reste une librairie indépendante (
ruleshake-core). Un déploiement dédié à l'évaluation reste possible plus tard, avec le même jar et un autre profil, si une mesure le justifie.
La règle d'or de la migration : le même comportement d'abord, les évolutions ensuite. Avant de toucher au code, Claude a capturé un golden master : les réponses des anciens services à un jeu de scénarios. Chaque étape devait les rejouer à l'identique. Les rares écarts acceptés sont listés et justifiés dans le plan de migration, tenu à jour à chaque étape.
Les données de la démo ont été migrées de MongoDB vers PostgreSQL par des scripts dédiés : collections, centaines de variables, publications, versions déployées, datasets et classifiers, sans aucun document rejeté. Les anciennes URL publiques continuent de fonctionner grâce à une réécriture dans Traefik : les clients de l'API n'ont rien à changer.
Un nouveau Studio
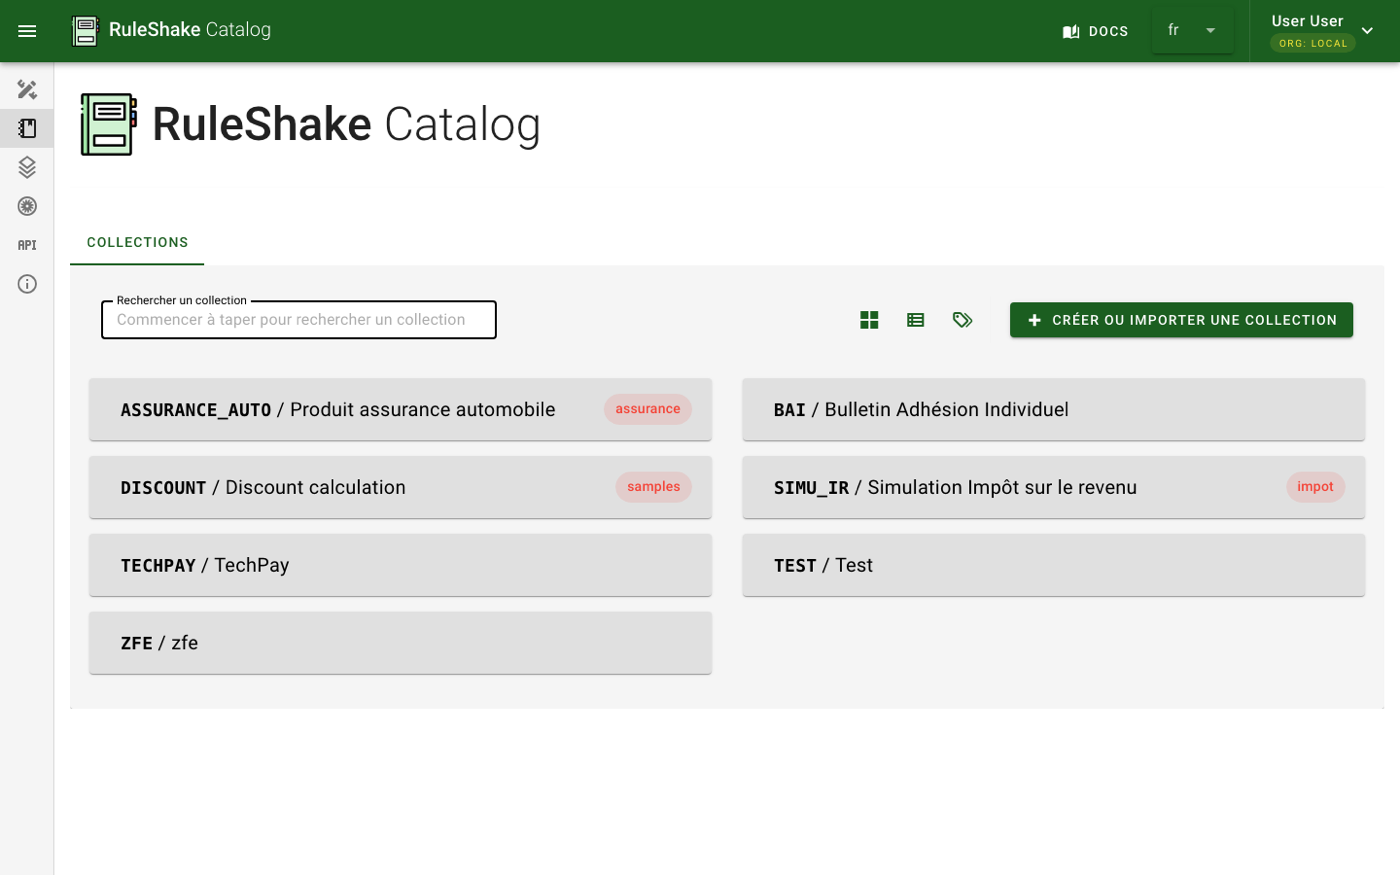
RuleShake Studio utilisait Vuetify depuis ses débuts. Il passe à shadcn-vue et Tailwind CSS v4, avec un thème plus proche de ce site, en gardant le vert de RuleShake.
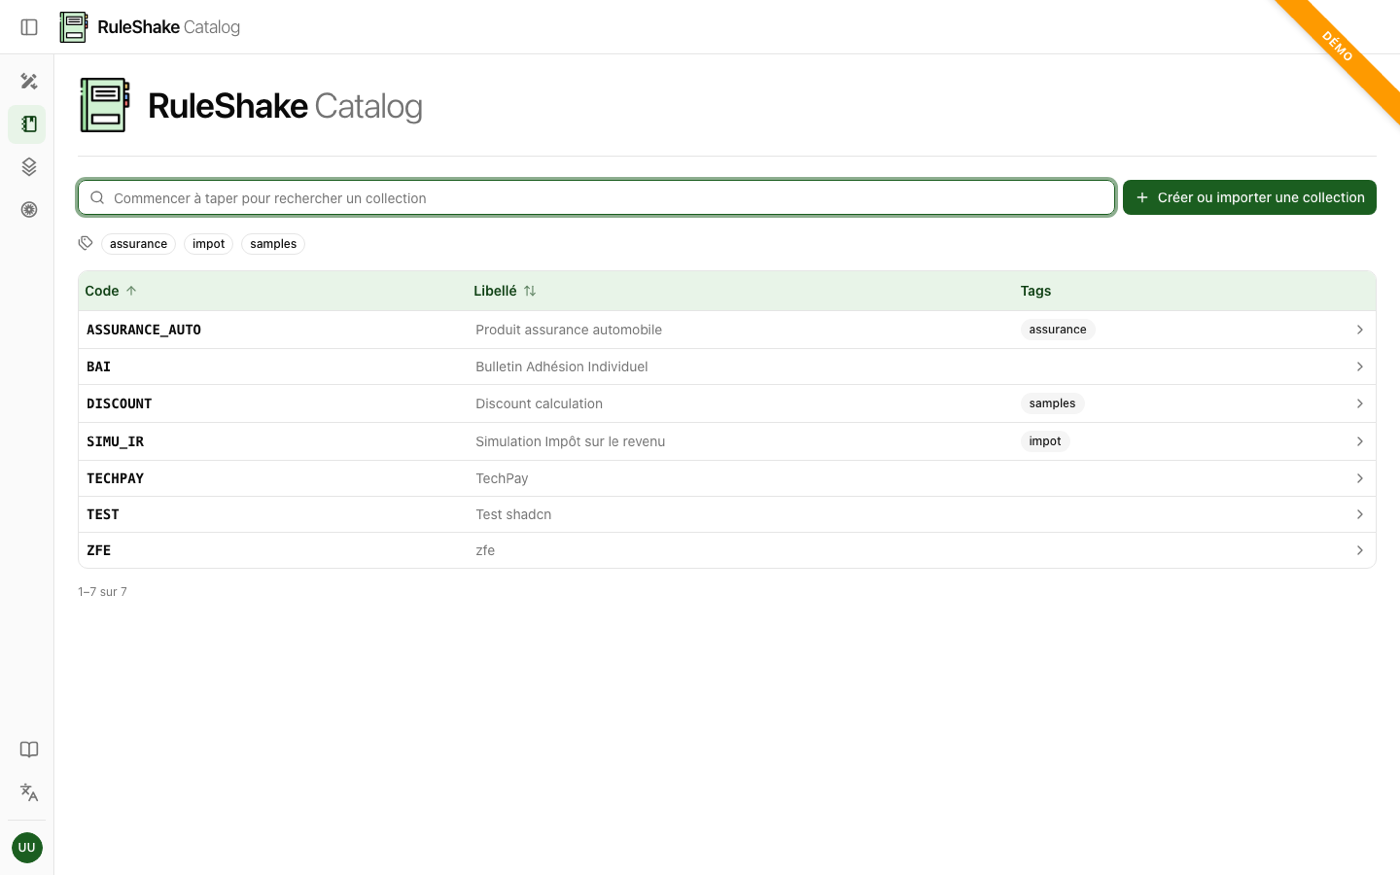
La liste des collections, avant puis après :
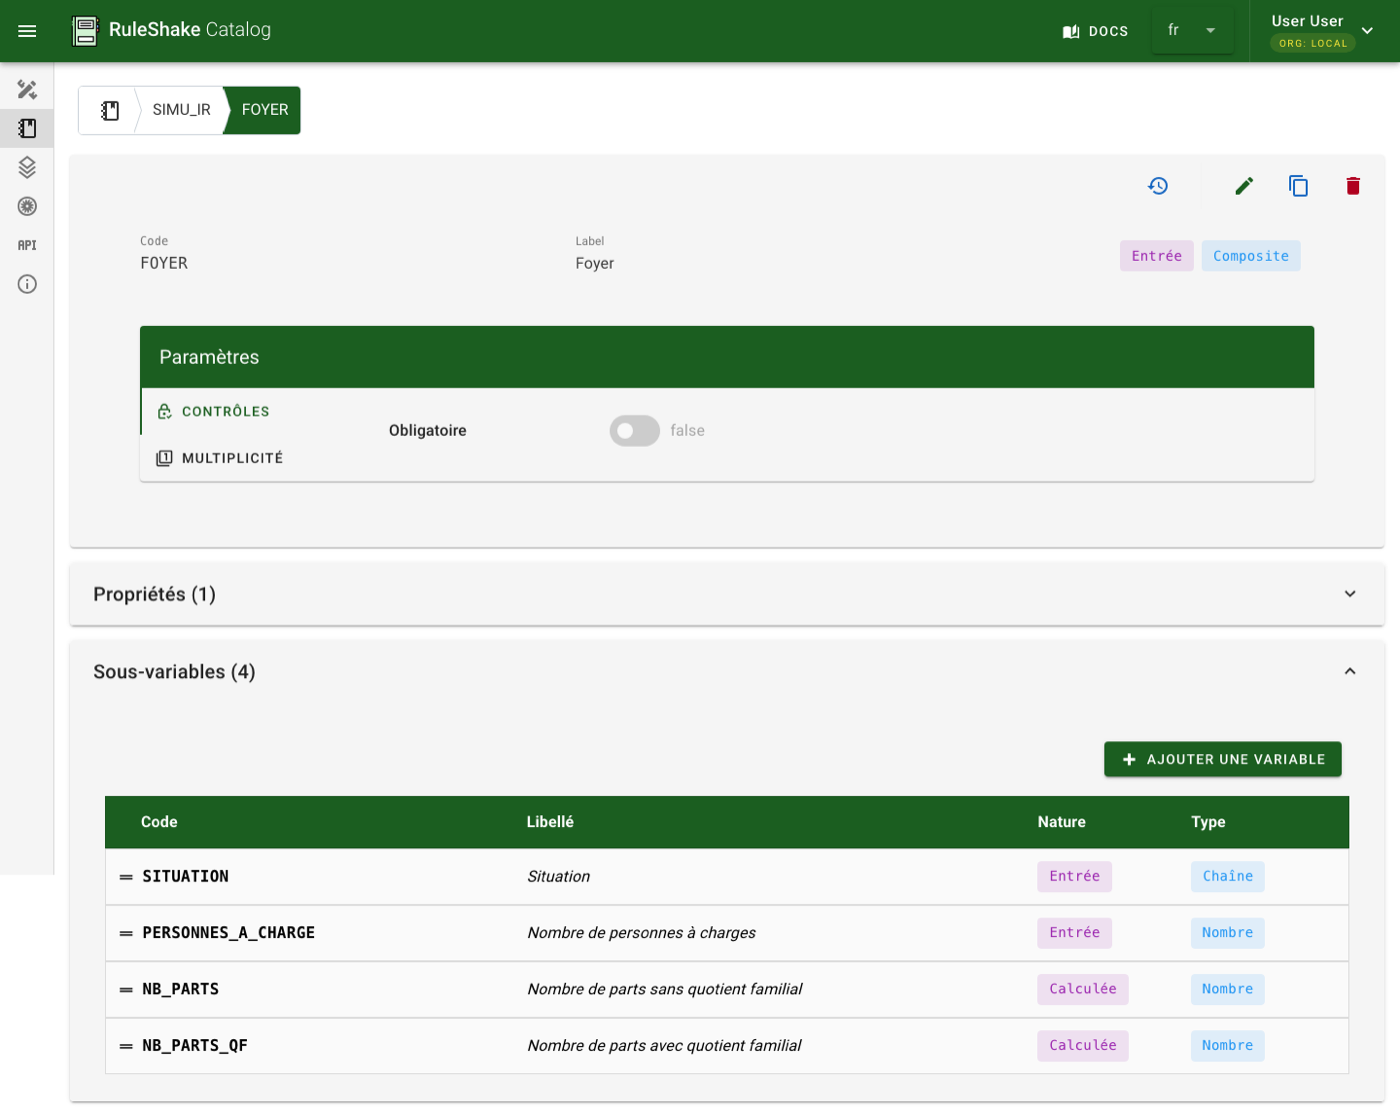
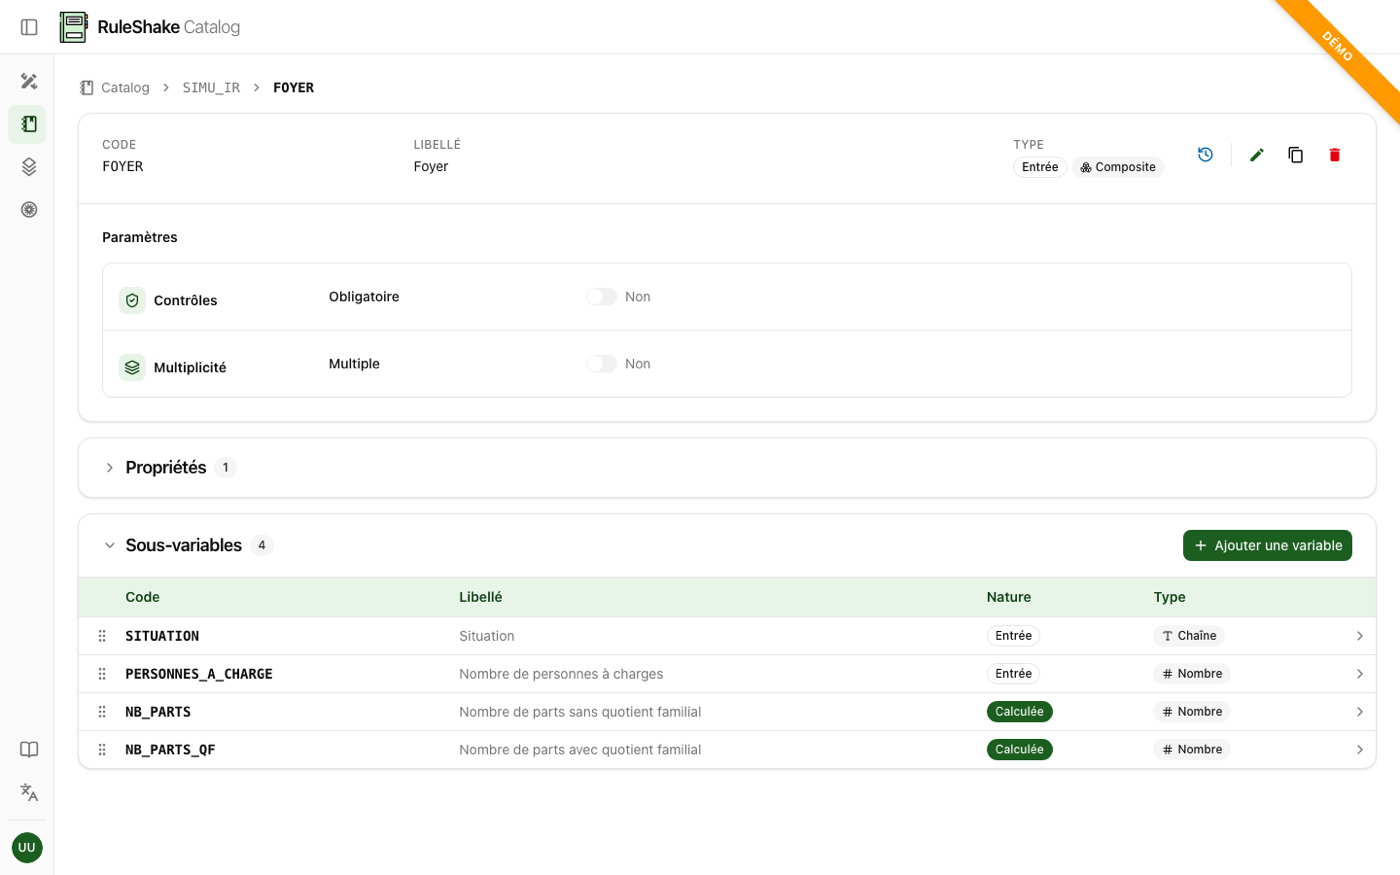
Le détail d'une variable, avant puis après :
- les listes de collections, datasets et classifiers sont des tableaux triables, avec recherche et filtre par tags, à la place des tuiles ;
- les paramètres d'une variable sont regroupés par thème (contrôles, bornes, précision, format, multiplicité) au lieu d'onglets latéraux ;
- toutes les dépendances ont été mises à jour (Vite 8, Vue 3.5, Pinia, Vue Router…), et le bundle est passé de 6,8 Mo à 3,8 Mo ;
- un lien vers Studio partagé sur WhatsApp ou Slack affiche maintenant un vrai aperçu.
Le vrai sujet : Claude
Je veux être clair sur un point : ce travail a été fait par Claude. Seul, sur mon temps libre, il m'aurait fallu des jours, probablement bien plus, pour arriver au même résultat. Et honnêtement, une migration de cette taille, je l'aurais sans doute repoussée encore longtemps.
Ce qui m'a impressionné, ce n'est pas seulement la vitesse à laquelle le code s'écrit. C'est la méthode :
- un plan d'abord, écrit et tenu à jour dans le dépôt, étape par étape, avec les décisions et les écarts constatés ;
- des filets de sécurité avant de casser quoi que ce soit : le golden master, des scripts de comparaison entre anciens et nouveaux services, des tests d'intégration sur un vrai PostgreSQL ;
- la vérification de son propre travail : Claude lance l'application, se connecte à Studio dans un navigateur, fait des captures d'écran et constate lui-même qu'un tableau est mal aligné ou qu'une liste déroulante fait sauter la page ;
- les finitions : une entête de tableau qui ne suit pas les coins arrondis, un curseur qui ne change pas sur les boutons, un volume Kubernetes dont la classe de stockage ne peut plus changer. Je signalais, c'était corrigé dans la foulée, sans que rien d'autre ne casse ;
- l'infrastructure aussi : déploiement sur Kubernetes, registre d'images local, secrets chiffrés. Je lançais les commandes sur le cluster, il lisait les erreurs et proposait la correction.
J'ai gardé la main sur l'essentiel : les choix d'architecture et d'infrastructure, et chaque commit, que Claude me demandait de valider avant de l'enregistrer. Il n'est pas infaillible : un script de nettoyage de mon registre d'images a effacé plus qu'il ne fallait. Mais il a détecté l'erreur lui-même, l'a réparée en quelques minutes en reconstruisant les images, et a corrigé et testé le script avant de me rendre la main.
Et maintenant ?
Ce weekend a changé ma façon de voir le développement d'un projet comme RuleShake. Les chantiers que je repoussais faute de temps deviennent faisables.
Le premier : remplacer MVEL, le moteur d'évaluation des formules. Ce sera peut-être aussi l'occasion de libérer l'ordre des variables, qui doit aujourd'hui suivre l'ordre du calcul.
Le monolithe débloque aussi les modules annoncés sur la roadmap. Ajouter un module ne veut plus dire créer un nouveau service, avec son déploiement, sa base et sa sécurité : c'est un nouveau module dans ruleshake-server, qui appelle directement les autres.
- Bulker pourra lancer des évaluations en masse en appelant directement le module d'évaluation, sans passer par le réseau ;
- Contents pourra produire des documents (un devis détaillé, par exemple) à partir du résultat d'une évaluation ;
- Forms pourra générer des formulaires dont les champs sont liés aux variables d'une collection.
On en reparlera ici.